在电脑上安装 Ollama、运行本地 AI 大模型,已经成为不少 AI 爱好者的日常。无论是聊天、写代码,还是处理各种文本任务,本地模型都有不少值得探索的玩法。但除了这些常见用途,其实还有一个很实用的场景,就藏在我们每天使用的浏览器里。
比如,让电脑上的 AI 模型直接帮你看懂外语网站。
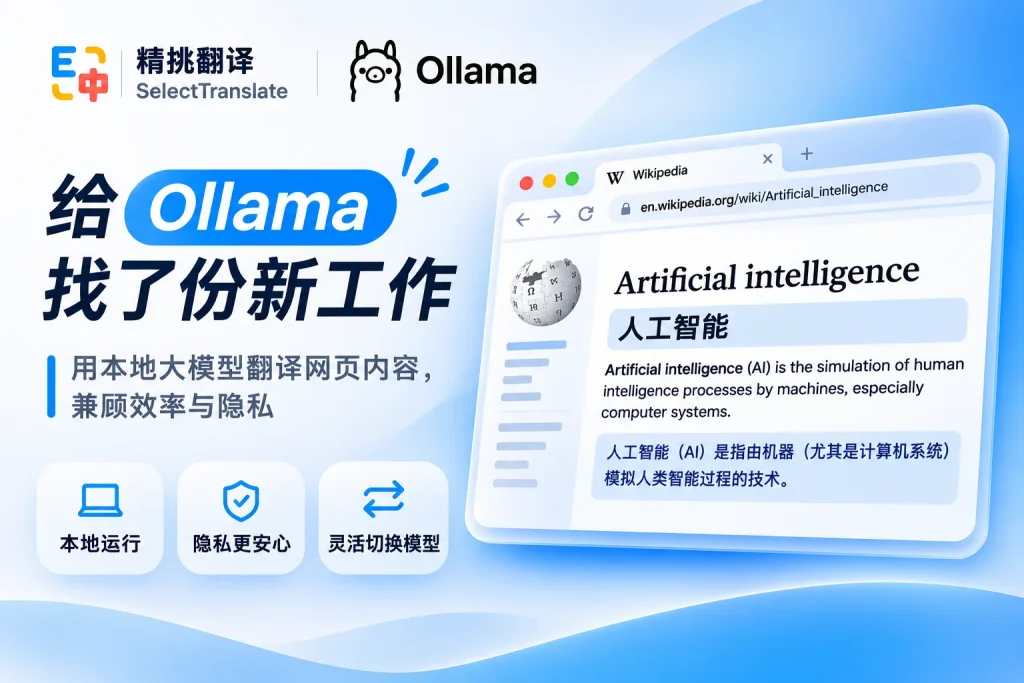
借助 Ollama 和精挑翻译(SelectTranslate),就可以将本地运行的 AI 模型接入浏览器,直接翻译网页内容,在原页面中查看译文。无需反复复制粘贴,也不必每次都调用云端翻译模型。
当本地 AI 遇上浏览器
平时阅读英文技术文档、海外新闻或国外论坛时,遇到看不懂的内容,我们可能会习惯性地复制到 AI 聊天窗口,等待翻译完成后,再返回原网页继续阅读。如果只是一两句话,这种方式倒也方便,但面对整篇文章或多个外语网站时,频繁切换窗口就显得有些麻烦。
既然 AI 模型已经运行在自己的电脑上,为什么不让它直接处理网页内容呢?
精挑翻译支持接入通过 Ollama 运行的本地大模型。完成配置后,就可以使用本地 AI 直接翻译外语网页,译文显示在当前页面中,不必将内容转移到其他工具。
例如,阅读 GitHub 上的英文项目文档时,可以一边查看原文,一边理解对应的中文译文;浏览海外资讯或技术社区时,也能够直接阅读翻译后的内容,让阅读过程更加连贯。
精挑翻译支持双语对照和仅译文两种网页阅读模式。前者保留原文与译文,方便理解内容和核对专业术语;后者则适合希望直接阅读翻译内容的用户。
本地 AI 翻译和云端翻译有什么不同?
如果只是为了看懂外语网页,使用云端 AI 翻译已经十分方便。那么,为什么还要尝试在自己的电脑上运行模型?
两者最大的区别,在于模型运行的位置、使用成本以及数据处理方式。
| 对比项目 | 本地 AI 翻译 | 云端 AI 翻译 |
|---|---|---|
| 使用费用 | 本地推理免费,不按 Token 收取云端调用费 | 可能有免费额度,也可能按 Token 或订阅收费 |
| 数据隐私 | 翻译文本可在本机完成模型推理,无需提交给云端 AI | 翻译文本通常需要发送至服务商服务器 |
| 网络依赖 | 模型下载完成后,本地推理无需联网 | 调用云端模型需要网络连接 |
| 运行性能 | 取决于电脑硬件和模型大小 | 主要由服务商计算资源和网络情况决定 |
| 模型选择 | 可以自行下载、切换支持的本地模型 | 选择取决于服务商提供的模型 |
| 使用门槛 | 需要下载模型并完成本地配置 | 通常无需自行部署,开箱即用 |
对于已经使用 Ollama 的用户,本地翻译尤其值得尝试。
首先是成本。 本地模型运行不需要按 Token 购买云端 API 调用额度,也没有模型推理次数的云端计费限制。对于经常阅读大量外语资料的用户来说,这是一个很实际的优势。当然,电脑运行模型仍然需要消耗电力和计算资源。
其次是隐私。 使用完全在本机运行的模型时,翻译文本可以在自己的电脑上完成 AI 推理,而不必发送给外部模型服务商。这对于阅读内部资料、技术文档或其他不希望提交给云端 AI 的内容,提供了更多自主选择。
需要注意,这里的“本地处理”指的是模型推理本身,不代表整个浏览过程完全离线,也不能保证扩展其他功能没有网络请求。网页访问、同步及其他服务仍需根据具体配置判断。
如何让 Ollama 开始这份新工作?
实际操作并不复杂,只需要准备本地模型、连接精挑翻译,再选择模型进行网页翻译即可。
第一步:准备 Ollama 本地模型
如果还没有安装 Ollama,可以前往 Ollama 官网 下载适用于 macOS、Windows 或 Linux 的版本。
安装完成后,进入 Ollama 模型库,选择适合自己电脑配置、支持所需语言的本地模型,按照模型页面的说明下载并运行。
如果已经安装过模型,可以在终端执行以下命令查看:
ollama list
建议先使用一小段外语文本测试模型的翻译能力。不同模型的语言支持、翻译质量和运行速度存在差异,并不是所有模型都适合网页翻译。
第二步:在精挑翻译中连接 Ollama
安装 精挑翻译 浏览器扩展,进入扩展设置,在【翻译模型】中找到 Ollama 对应的配置选项。
填写已经安装的本地模型名称,并确认 API 接口地址。Ollama 默认的本地服务地址为:
http://localhost:11434
模型名称需要与 Ollama 中实际安装的名称保持一致,接口地址则以扩展中相应配置项的要求为准。
完成设置后,检查模型能否正常连接。如果出现连接失败或跨域访问问题,可以参考 Ollama 官方 FAQ,按需设置浏览器扩展的访问权限,并重启 Ollama。
第三步:使用本地 AI 翻译网页
保持 Ollama 本地服务正常运行,打开精挑翻译扩展面板,选择已经配置好的 Ollama 模型。
接着打开需要阅读的外语网站,使用精挑翻译的网页翻译功能,即可让本地模型处理网页文本,并在当前页面查看翻译结果。
根据自己的阅读习惯,还可以选择双语对照或仅译文模式。整个操作过程与平时使用网页翻译基本一致,区别在于背后负责处理文字的是运行在自己电脑上的 AI 模型。
本地模型一定比云端更好吗?
本地 AI 翻译有免费调用、数据本地处理和模型自主选择等优势,但并不意味着它适合所有人。
本地模型需要占用电脑的内存和计算资源。如果模型规模较大、电脑性能有限,翻译长网页时可能出现响应较慢的情况。另外,不同模型在语言理解、专业术语和长文本翻译方面的表现也会有所不同。
相比之下,云端模型无需自行部署,通常更适合希望直接使用、减少配置步骤的用户。
好在精挑翻译同时支持本地模型和多种云端翻译模型。用户可以根据实际需求选择:日常阅读时使用本地模型,遇到要求较高的翻译任务时,再切换到合适的云端模型。
两者并不冲突,关键是找到适合自己的使用方式。
让本地 AI 真正派上用场
本地大模型的价值,不只是能够在电脑上运行,更在于能否真正融入日常使用。
Ollama 负责运行本地 AI,精挑翻译则把模型能力带进浏览器。两者结合,让外语网页阅读多了一种选择:无需云端模型 API 调用费用,翻译文本可以在本地完成处理,还能直接享受双语对照阅读体验。
如果你已经在使用 Ollama,不妨给它安排这份新工作,看看电脑里的 AI 还能带来哪些便利。
了解更多: 精挑翻译官网 · Ollama 接入教程