AI 翻译现在真正难判断的地方,不是它翻得太差,而是很多结果已经足够自然。过去机器翻译一旦出错,常常能从生硬的语序、奇怪的用词里看出来;现在即使原文中的条件、程度或者范围发生变化,最后得到的中文依然可能十分流畅。
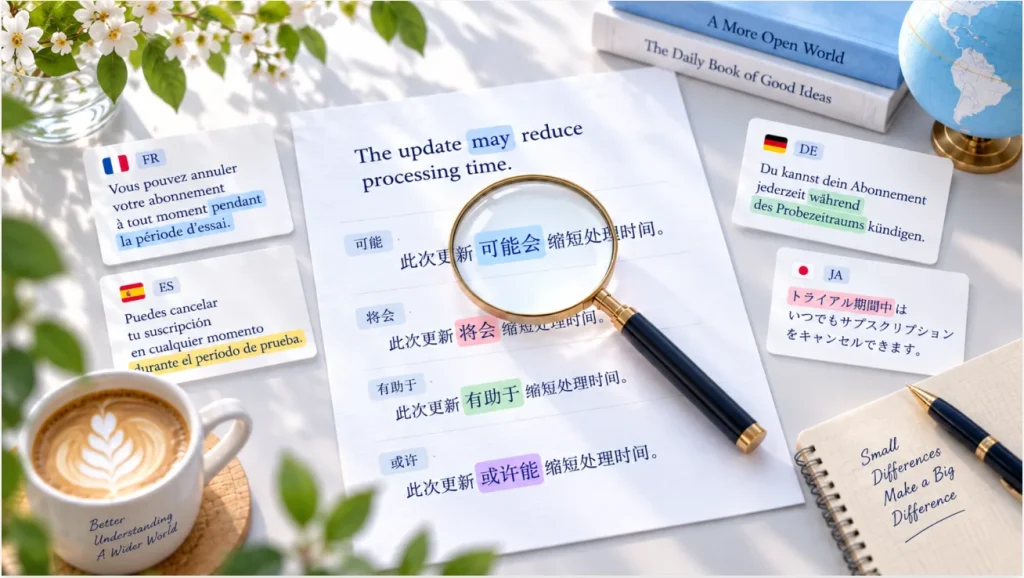
例如 The update may reduce processing time. 如果翻成“此次更新将缩短处理时间”,单看中文几乎没有问题。但原文中的 may 只是“可能”,译文却变成了更确定的“将会”。如果只是浏览普通网页,这种差异未必影响整体理解;但放在技术说明、商务资料或者研究内容中,就可能改变读者对原文的判断。
所以,判断 AI 翻译是否准确,不能只看译文读起来顺不顺。更实际的方式是:先看这份译文准备拿来做什么,再确认原文中那些不能随意改变的信息有没有被保留下来。
先看用途,再决定需要检查到什么程度
不是所有 AI 翻译都需要逐句核对。如果只是阅读海外新闻、论坛帖子或者普通网页,主要目的通常是快速理解内容。某个词翻成“改善”还是“提升”,一句话是不是最自然,大多数时候并不会改变对全文的理解。
但如果译文会用于技术操作、论文阅读、商务沟通或者正式发布,要求就不一样了。一句话涉及时间、金额、责任、条件或者操作要求时,即使只是一个词发生变化,也可能影响后续判断。
| 使用场景 | 更值得重点检查的内容 |
|---|---|
| 新闻、论坛、普通网页 | 核心事实和主要意思 |
| 技术文档 | 条件、参数、数字、操作要求 |
| 论文与研究资料 | 数据、因果关系、研究结论 |
| 商务沟通 | 时间、责任主体、承诺程度 |
| 长篇文档 | 术语一致性、上下文和指代 |
| 法律、医疗、财务等高风险内容 | 专业含义和关键事实,需要进一步确认 |
可以用一个很简单的问题判断:如果这里翻错,会不会影响我接下来怎么做? 如果不会,没有必要把普通阅读变成专业审校;如果会影响实际操作、沟通或者决策,就值得进一步确认。
真正容易改变意思的,往往不是难词
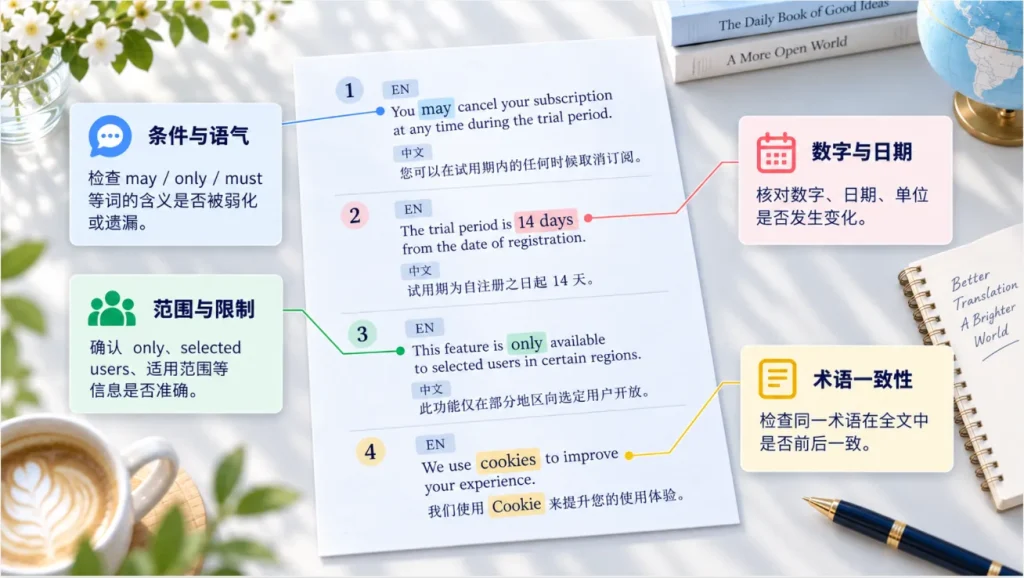
很多翻译问题并不是出在复杂的专业词汇上,而是 may、only、must、unless、at least 这些很普通的词。它们决定了一句话有没有限制、事情是否确定,以及要求到底有多强。
例如 This feature is available only when synchronization is enabled. 如果翻成“开启同步后可以使用此功能”,读起来没有明显问题,但原文强调的是“只有开启同步才能使用”。再比如 Users may need to restart the application. 如果变成“用户需要重新启动应用”,“可能需要”就变成了明确要求。
范围也很容易在翻译过程中发生变化。The feature is currently available to selected users. 如果翻成“该功能目前已向用户开放”,原文中的 selected users 就被忽略了。“部分用户”变成了容易被理解为“所有用户”,但整句话依然十分自然。
因此,检查重要译文时,不需要重新研究每一个词。优先确认否定、条件、程度、范围、时间和主体有没有变化,通常更容易发现真正影响原意的问题。
数字和术语,是最适合快速检查的部分
面对一篇长文,从第一句重新核对到最后一句既慢,也没有必要。数字、日期、单位、版本号和专有名称则不同,它们几乎没有多少表达空间,一旦发生变化,影响通常也比较直接。
比如 Requests are limited to 100 per minute. 可以翻成“每分钟最多允许 100 次请求”,也可以写成“请求限制为每分钟 100 次”,但 100、每分钟 和“限制”这些关键信息不能变化。论文中的数据、产品规格里的参数,以及商务资料里的金额和日期,都适合单独快速检查一次。
长内容还需要留意术语是否前后一致。同一个 workspace 如果前面翻成“工作区”,后面又变成“工作空间”,单独看都没有明显错误,但放到整篇文档里,就可能让读者误以为它们是两个不同概念。
比较省时间的方式,是先正常把译文读完,再快速扫一遍数字、名称和几个核心术语。相比从头重新审一遍全文,这样更容易发现真正值得处理的问题。
拿不准时,多看一个结果是为了发现分歧
遇到一句自己不确定的译文,再换一个翻译结果进行比较是有价值的。不过,多一个结果并不意味着可以简单通过“多数投票”判断哪一个正确。
如果同一句原文分别出现“必须开启”“建议开启”和“满足特定条件时开启”,最值得注意的不是哪一种说法出现得更多,而是这些结果已经在条件和强制程度上出现明显分歧。这种分歧本身就是一个信号,说明这一句值得重新回到原文确认。
反过来,如果几个结果只是“开启同步”“启用同步”这样的措辞区别,而主体、条件、数字和结论都一致,就没有必要继续比较。多个结果真正有价值的地方,是帮助找到哪些句子值得重新判断。
如果还想了解 GPT、Gemini、Claude、DeepSeek、DeepL、Google 翻译等不同方案本身有什么区别,可以参考 AI 翻译模型怎么选?GPT、Gemini、Claude、DeepSeek、DeepL 与 Google 翻译对比。
内容变长后,比较译文也会产生新的成本
比较一两句话并不麻烦,但内容一旦变成几个段落甚至一篇长文,逐个切换不同翻译结果本身也会增加工作量。有些句子几个结果完全一致,有些只是表达方式不同,真正存在含义分歧的可能只有少数几句。
精挑翻译的 择优翻译 可以同时获得多个翻译结果,再通过评分、逐句择优和分析帮助缩小比较范围。它的作用并不是证明“评分最高的结果一定正确”,而是减少人工逐份阅读和切换译文的成本。
比如一段内容有五句话,前四句结果基本一致,只有最后一句在“必须”“建议”和“可能”之间出现明显差异,那么真正需要重新判断的就是最后一句。相比从头比较几份完整译文,这种方式更容易把时间留给真正可能改变原意的地方。
总结
AI 翻译越来越自然以后,最容易被忽略的错误,已经不一定是明显的病句,而是那些读起来完全正常,但条件、程度、范围、数字或者主体已经发生变化的译文。
判断一份 AI 译文能不能直接使用,也不需要把全文重新翻一遍。先看它准备拿来做什么,再重点检查那些一旦变化就会影响意思的信息;真正拿不准的地方,再通过其他结果看看分歧到底发生在哪里。
流畅解决的是“好不好读”,准确解决的是“原意有没有变”。判断 AI 翻译时,这两件事最好不要混在一起。
常见问题 FAQ
译文读起来很自然,就一定准确吗?
不一定。表达自然只说明译文比较流畅,并不代表原文中的条件、范围、数字和主体都被完整保留下来。有些最难发现的翻译问题,恰恰不会影响句子的自然程度。
普通网页翻译需要逐句检查吗?
通常没有必要。如果只是浏览新闻、论坛或者普通网页,能够准确理解主要内容基本已经足够。只有当译文会影响操作、发布或者决策时,才值得投入更多检查时间。
多比较几个翻译结果,会更准确吗?
不一定。多个结果更大的价值是帮助发现分歧。如果只是措辞不同,可以不必继续比较;如果在条件、数字、主体或者结论上出现明显差异,就值得重新确认原文。
AI 翻译可以直接用于论文、合同或专业资料吗?
可以用于理解和辅助处理,但内容越专业、使用后果越重要,就越需要进一步确认。关键数据、研究结论、责任条款和专业术语不适合只依赖自动翻译。
择优翻译评分最高的结果就是正确答案吗?
不是。评分主要用于帮助缩小比较范围,并不能代替对原文的判断。对于重要内容,仍然需要结合上下文确认译文是否准确。